Mostrando entradas con la etiqueta javascript. Mostrar todas las entradas

EL EDITOR

Se presenta EL EDITOR, que mezcla parte del trabajo realizado en el editor de vocabulario, incorporandolo sobre el editor rdf, implementado de esta forma un editor que cumple con vocabulario visual.

VER DEMO

El siguiente esquema representa la jerarquía de clases Javascript para la implementación (ver source):


Caracterizando la implementación de Gobierno Transparente


La implementación para cumplir la "Ley N° 20.285 - sobre Acceso a la Información Pública", denominada "Gobierno Transparente", tiene un sabor a "linkeddata". La opción tradicional implicaba implementar un sistema centralizado, donde se cargan los datos y permite consultar. Recordemos que la forma de cumplir con la normativa de publicar los datos en la web, se implementó con un modelo distribuido pero asistido, pasando por el siguiente flujo para cada servicio:

- Bajar las planillas desde http://www.gobiernotransparente.cl/

- Llenar las planillas con los datos respectivos (*)

- Utilizar los asistentes disponibles para generar las páginas con los datos, url (**) e índices

- Subir la información a cada sitio web (***)


Las particularidades corresponden a los puntos con asteriscos, que presentan una similitud con el modelo de datos linkeados en la web (linkeddata):

(*) Lo que se está haciendo al llenar una planilla es "crear instancias de una clase", asi cada fila de la planilla es una "instancia de la clase que define la planilla" con las "propiedades detalladas en el encabezado de la hoja". En la práctica, la planilla es "el esquema".
(**) Algunas url están "linkeando" a otros sistemas, que luego pueden extenderse con más información, ver por ejemplo listado de urls de "chileclic", y listado de urls del "Registros Ley N° 19.862".

(***) Al publicar las páginas en cada sitio, se da libertad para "ajustar" el formato de las páginas y urls.

Al utilizar un modelo distribuido, se tienen problemáticas similares a las de "linkeddata":

- Se requiere tipos de datos estrictos (e.g. para fecha, valores)

- Existe una evolución de vocabulario (e.g. cambio de planilla para dotación entre años)

- Es necesario contar con taxonomias para realizar agregación automática (e.g. nombre de servicios/instituciones, tipo de pagina)

Existen pocas soluciones de este tipo y quitando el antecedente del formato en que se serializan los datos, se tiene una oportunidad, ya que "conceptualmente el problema es el mismo que si tuvieramos los datos con RDF", en particular están incluidos los problemas listados anteriormente. Bajo este análisis y convencido cada vez más que la fuente de datos del "Gobierno transparente" puede ser explotada ahora, he comenzado con una serie de tareas que permitan caracterizar mejor los sub-sitios que mantiene cada servicio. Estas tareas son:

1.- Construir un listado de instituciones con páginas de transparencia

2.- Implementar un "sistema asistido" para: clasificar las páginas y rescatar los esquemas

3.- Presentar opciones de consulta que permita caracterizar cada sub-sitio


Construir un listado de instituciones con páginas de transparencia

Anteriormente ya se tenía un listado de instituciones, ahora se presenta el listado actualizado, con mas antecedentes y con opciones de filtrado (ofrecidos por exhibit). El listado es mantenido en una hoja de google spreadsheets.

Ver listado.

La información del listado proviene del sitio chileclic y se puede complementar con la información existente en la Dirección de Presupuesto, del Ministerio de Hacienda.

Implementar un "sistema asistido" para: clasificar las páginas y rescatar los esquemas

Mediante un sistema de bookmarklet y gracias a que cada página de los sub-sitios mantienen un formato estandarizado, es posible rescatar la siguiente información: url, institución, clase, periodo, actualización y esquema. Los datos son presentados para que puedan ser editados (funciona como una ventana de delicious o un bookmarklet de diigo) y luego son enviado mediante un formulario a una hoja de google spreadsheets.

La parte novedosa de esta herramienta consiste en utilizar un algoritmo de similaridad de strings (levenshtein) para buscar y normalizar el nombre de la institución, para ello es mandatorio contar con la lista de instituciones (descrita en el punto anterior).

Copiar el bookmarklet ClasificadorTransparencia a la barra de marcadores.


Presentar opciones de consulta que permita caracterizar cada sub-sitio

Utilizando opciones de filtrado y facetas (ofrecidos por exhibit), es posible "recorrer" el listado de páginas y esquemas recolectados con la herramienta del "sistema asistido", permitiendo caracterizar el número de páginas por institución, categoría, año y tipo.

Consultar características de páginas para 20+ instituciones.

Los pasos siguientes son:

1.- agregar opciones avanzadas para detectar clase (tipo de página), la consecuente categoría y parsear mejor el periodo

2.- permitir actualizar la clasificación de una página y dar opciones de colaboración

3.- recolectar las instancias de cada página, para ello ya se tiene un prototipo para el bookmarklet de DatosTransparencia

4.- presentar opciones para caracterizar y consular las instancias


Día 1

Ayer fue el primer día de trabajo full time en la universidad. Lo mejor de todo fue trabajar desconectado de la red, realmente fue provechoso. El avance estuvo por el lado del editor rdf, el que permitirá integra las figuras del Vocabulario Visual, con lo que se podrá anotar vocabularios owl con rdf. Ayer quedaron listos las figuras para cada componente, y además se puede agregar propiedades a una clase. Falta administrar el rango-dominio de una propiedad, crear los conectores de tipo herencia y el de individual.

Ver en el update del repositorio los cambios en el código. Para muestra un screenshot de como está quedando el editor.


Parser rdf en javascript

Para implementar la funcionalidad de "importar triples", en el Editor RDF, es necesario utilizar un parser de documentos rdf. La primera problemática asociada al parser, es la inmensidad de serializaciones existentes para los modelos RDF, sólo para nombrar algunos: xml, xml-abbrev, n3, ntriple, json, trix, trig, turtle. Tomando sólo el caso de xml, que por ser el primero debiera estar mas desarrollado, se encuentra que existen, al menos, los siguientes parser disponibles:
En todos estos parser falla, al menos, el siguiente ejemplo:

Desde: http://openlibrary.org/b/OL10208782M.rdf
<rdf:RDF
  xmlns:bibo='http://purl.org/ontology/bibo/'
  xmlns:rdfs='http://www.w3.org/2000/01/rdf-schema#'
  xmlns:rdf='http://www.w3.org/1999/02/22-rdf-syntax-ns#'
  xmlns:dcterms='http://purl.org/dc/terms/'
  xmlns:dc='http://purl.org/dc/elements/1.1/'
>
    <rdf:Description rdf:about="http://openlibrary.org/b/OL10208782M">
          <bibo:authorList rdf:parseType="Collection">
            <rdf:Description rdf:about="http://openlibrary.org/a/OL2668863A">
               <rdf:value>Michael C. Rea</rdf:value>
            </rdf:Description>

          </bibo:authorList>
        <dcterms:title>Arguing About Metaphysics</dcterms:title>
        <dcterms:publisher>Routledge</dcterms:publisher>   
        <dcterms:issued>July 1, 2008</dcterms:issued>
        <dcterms:extent>559</dcterms:extent>
        <bibo:edition>1 edition</bibo:edition>
        <dc:subject>Metaphysics</dc:subject>
    </rdf:Description>
</rdf:RDF>

El error se presenta en la sección de Collection (en azul) y ninguno de los parser logra generar los triples asociados de forma correcta.

Una primera opción, para sobrepasar esta dificultad, es implementar un parche que soporte el ejemplo anterior, sobre alguno de los parser rdf/xml en javascript. Además, se puede validar contra los casos de prueba de rdf. Todo lo anterior requiere un esfuerzo no menor, el que puede ser inútil si no se mantiene en el tiempo. Otra opción es implementar el parser por el lado del servidor, utilizando un parser maduro como Raptor, pero es una complicación ya que el Editor RDF es una aplicación javascript sin componente de servidor.

Investigando en la línea de Raptor, encontré el servicio llamado triplr que permite generar triples rdf desde una url, este servicio es obra de Dave Beckett el mismo autor de Raptor. La forma de utilizar el servicio es simple y consiste en llamar una dirección de la forma siguiente:

    http://triplr.org/<formato de salida>/<url del documento rdf, con http:// opcional>

Las opciones de formato de salida son:

(copiado desde http://triplr.org/how)
HTML - use html
JSON - use json
N-Triples - use ntriples
RDF/XML - use rdf (this is also the default)
RSS 1.0 - use rss: removed since people abused this to proxy other RSS feeds.
Turtle - use turtle (n3 also works)

Para el ejemplo que tiene problemas con los parser javascript y con una salida en html la forma de invocar el servicio es: http://triplr.org/html/openlibrary.org/b/OL10208782M.rdf. Como vemos, la colección es identificada de forma correcta. Para utilizar este servicio en el Editor RDF se puede invocar con la salida de tipo json, y gracias al uso de yahoo pipe se puede utilizar como jsonp para sobrepasar la política del mismo origen.

Una vez resuelto el problema del parser, aún queda el problema de la multiplicidad de serializaciones, la solución está en el mismo triplr que soporta los siguientes tipos de documentos rdf: atom, grddl, n3, ntriples, rdf, rdfa, rss, trig, turtle. Como una prueba de concepto, ver el siguiente ejemplo de implementación con la llamada del pipe que invoca triplr.

Editor RDF (I)

Durante las últimas semanas he trabajado en desarrollar un editor rdf, el objetivo principal es re-escribir el código de vocab-editor y de paso tener una herramienta que permita, gráficamente, la creación de triples RDF.

Un primer prototipo se encuentra disponible en el repositorio svn.

Último prototipo editor

Se presenta el último prototipo del editor de esquemas, esta vez contiene gran parte de las funcionalidades ideadas inicialmente, permitiendo:
  • Agregar/Eliminar una clase
  • Agregar/Eliminar una propiedad
  • Enlazar una clase con otra clase (para indicar rdfs:subClassOf)
  • Enlazar una propiedad con una clase (para indicar rdfs:range)
  • Incrustar una propiedad en una clase (para indicar rdfs:domain)
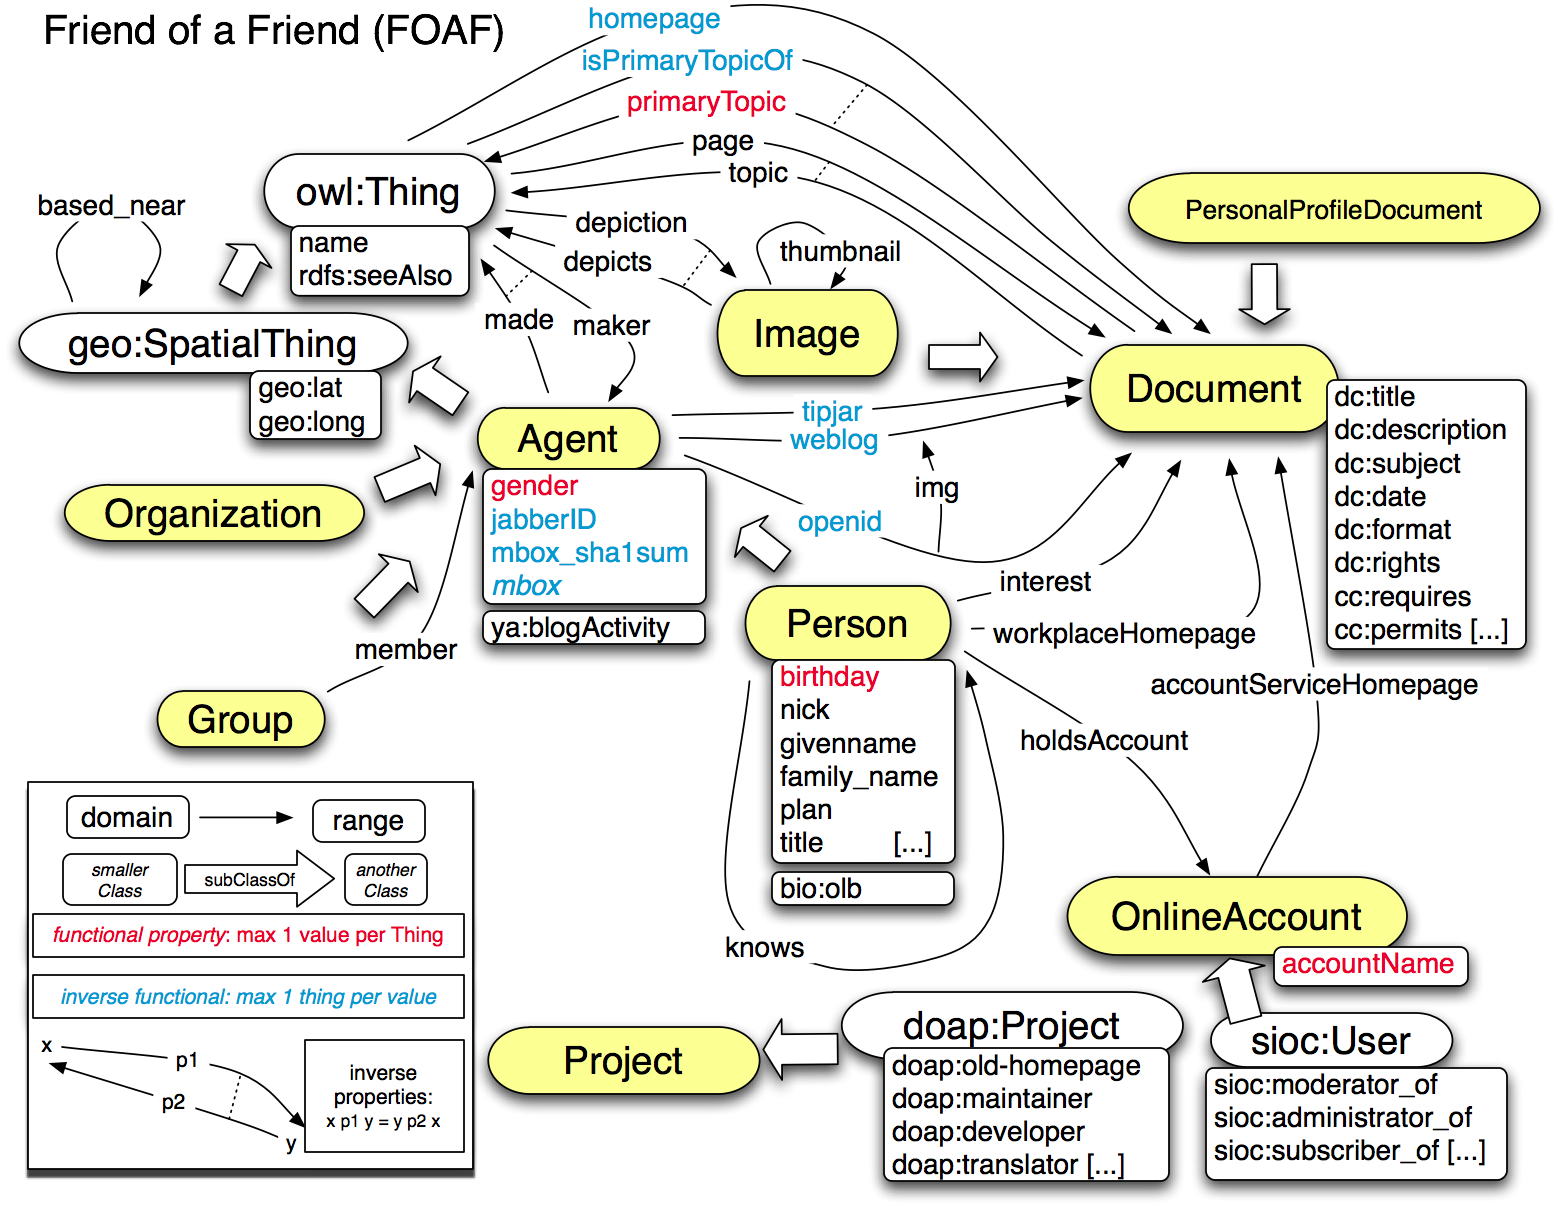
Nuevamente se presenta, como caso de ejemplo, el diagrama de foaf, esta vez se encuentra pre-cargado al ingresar al prototipo.


Dentro de las funcionalidades a implementar para la primera versión del editor están:
  1. Grabar esquema en servidor
  2. Manejar versiones (histórico)
  3. Listar diagramas en servidor (con nombre - fecha - namespace)
  4. Administrar namespaces (color, curie, url, etc)
  5. Importar rdfs
  6. Seleccionar datatypes (xml)
  7. Borrar un conector
  8. Quitar una propiedad de una clase y dejar sin dominio
  9. Ordenar propiedades en una clase
  10. Dejar como una vista el ocultar las propiedades (diagrama de clases)
  11. Dejar como una vista el mostrar todos los enlaces de rango (diagrama entidad relación)
Las bibliotecas JavaScript utilizados en el prototipos son:

Prototipo editor (2)

Se presenta un nuevo prototipo de la gui para el editor de esquemas. Esta vez ya están "cargadas" todas los esquemas y se pueden agrupar las propiedad que son del dominio de una clase. Como ejemplo se presenta el siguiente esquema que asimila el diagrama del proyecto DOAP .


En el prototipo se "perdió temporalmente" la opción de seleccionar el rango de una propiedad (uniendo una propiedad con una clase) y al hacer doble click sobre una clase se elimina.

Las bibliotecas JavaScript utilizados en el prototipos son:

Prototipo de editor

Se presenta el primer prototipo de la GUI para el editor de ontologías colaborativo. Las funcionalidades habilitadas permiten solo hacer un diagrama, además se tienen habilitadas las primeras seis ontologías solamente. El objetivo del editor es tener una herramienta que permita componer esquemas, reutilizando ontologías existentes. Como un ejemplo, se presenta el intento de reconstruir parte del esquema FOAF.


Como se puede ver en el ejemplo, o bien utilizando el prototipo, existen solo dos tipos de relaciones:
  • La primera es una relación dirigida (con flecha), que une dos clases, para representar la propiedad sub-clase.
  • La segunda relación permite unir una propiedad con una clase y es para indicar el rango de una propiedad.

El dominio de una propiedad esta dada por el contexto de orden sobre una clase, el cual se debe implementar con algún tipo de restricción visual (enmarcando clase con sus propiedades, por ejemplo). Además, se deben agregar restricciones de cardinalidad para las propiedades.

Una lista de características que debiera tener la versión 0.1 del editor es la siguiente:
  • Permitir selección de múltiples elementos con draging options, operaciones de move y delete
  • Eliminar clases y propiedades del diagrama
  • Mostrar y ocultar propiedades y sus relaciones de rango
  • Agrupar propiedades "dentro" de una clase
  • Ingresar cardinalidad en relación de propiedades
  • Exportar e Importar el diagrama
  • Activar puntos sin conexión solo ante un MouseOver

Javascript

Para la manipulación de rdf con javascript existen algunas soluciones destacadas:
  • PAC : permite crear formularios rdf
  • RDFQUERY : un plugin de JQUERY, donde se destaca el demo MARK IT UP!
  • TABULATOR: un browser generico para data en rdf, ver paper
  • OAT: una serie de herramientas AJAX de OpenLinkSW (los mismos de virtuosos)
  • DOJO DATA: una implementación para acceder un rdfstore
  • JALAVA: un editor de diagramas